Czas czytania artykułu
Fundament
Wokół nas poważni Inżynierowie budują poważną architekturę modeli językowych i może Ty pomyślałeś sobie, że też zbudujesz. I słusznie. Wiem, jesteś pracusiem i masz dostęp do dużej ilości tekstu. To po kolei.
Najpierw musisz zbudować tokenizer i słownik tokenów (to te od prawie sylab). Jak pamiętasz, już kiedyś wspólnie promptowaliśmy generowanie zdjęcia psa, to trzymajmy się tego psiaka. Fajne zwierzę.
Zatem, w Twoim słowniku tokenów (z którego tokenizer będzie wyciągał tokeny jak magik królika z kapelusza) pies – po angielsku dog – dostaje token ID-452. Ponieważ chcesz mieć wszystko solidnie zrobione, musisz określić ile będzie warstw sieci, ile wektor będzie miał liczb, jakie macierze będą potrzebne – no wybacz, sztuczne sieci neuronowe to czysta matma.
No i wiem, że masz ogrom tekstów, którymi możesz nakarmić model, ale zanim pokażesz mu pierwszy tekst treningowy, trzeba tym parametrom nadać wartości.
Parametry
Podsumujmy, bo już mamy lekki ból głowy.
Token – dog
Token ID – 452
Wektor. Potrzebujemy wektora! To Ty jako Inżynier określisz, ile liczb ma zawierać, a komputer wylosuje jego pierwsze wartości. Załóżmy, że token dog na początek dostanie taki wektor: [0.7, -0.3, 0.7, -0.6].
Do tego wszystkiego teraz muszą być wagi. Ale żeby zobaczyć, po co one są, wróćmy na chwilę do perceptronu. Pamiętasz perceptron? To ten od przeliczania wartości według wzoru i przekazywania sygnału dalej w sieci. Podobnie jak neuron w mózgu. To perceptron popycha informację dalej lub ją stopuje. A co właściwie przelicza? Wartości, które dostaje na swoich wejściach. Tak tak, na wejściach. Liczba mnoga, bo jeden perceptron ma wiele wejść.
Załóżmy, że budujesz jeden i musisz nadać mu wejścia. No to na przykład nadajesz cztery: x1, x2, x3, x4.
Jeden perceptron, cztery wejścia. Musiałam powtórzyć. To ten nawyk.
Perceptron potrzebuje przy każdym wejściu liczby, przez którą będzie mnożył wartość tego wejścia, na przykład: x1 x 0,3; x2 x -0,6; x3 x 0,9; x4 x 0,4.
I mamy wagi. To właśnie te: 0,3; -0,6; 0,9 i 0,4.
Nadane znaczenie
Wspaniale, masz już to poukładane. Przypominam, malujemy psa.
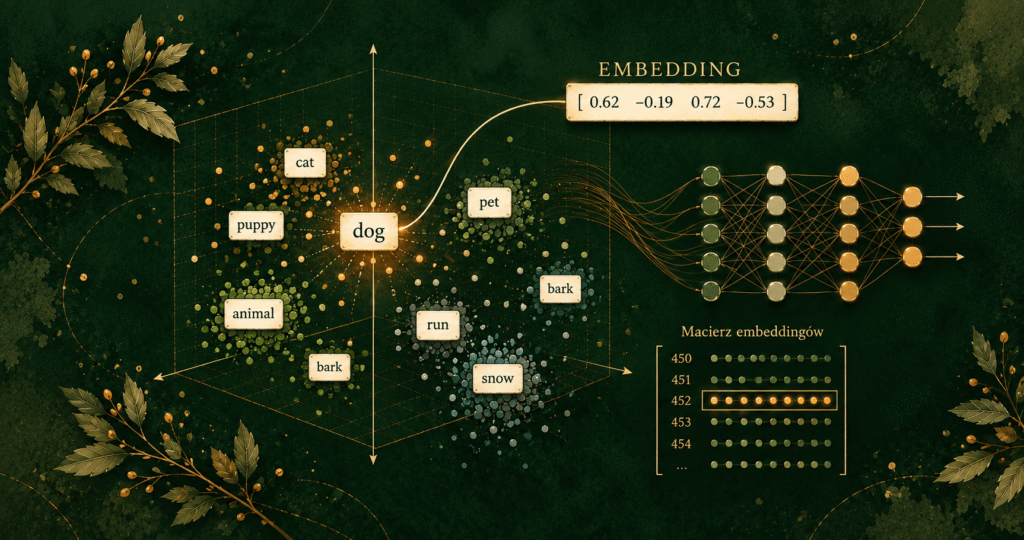
Masz token dog. Tokenizer wyciąga go ze słownika i sprawdzamy – tak zgadza się. Dog ma token ID-452. Nic się nie popsuło. Ale chwila. To, że ten token ma ID-452 naprawdę nic nie znaczy. Sieć jeszcze nic nie wie o słowie dog. Równie dobrze ten token mógłby mieć ID 453 i na to samo by wyszło. Czyli na razie na nic. I jeszcze ciekawostka. To, że jakieś tokeny mają sąsiadujące ID, na przykład 452 i 453 zupełnie nie oznacza, że są do siebie podobne, jak na przykład gdy Marcin ma 187cm wzrostu, a Marek 188cm to, że są podobnego wzrostu. To kompletnie nie tak. Kolejność numerów ID nie jest żadną mapą ich znaczeń.
Ale wracamy: masz już swój wektor [0.7, -0.3, 0.7, -0.6]. To Ty ustalasz wymiar wektorów. Dałeś cztery, ale mogłeś dać dwadzieścia jeden, ile chcesz. Natomiast ten wymiar wektorów będzie dotyczył wszystkich tokenów. Zatem wektor do tokena dog to [0.7, -0.3, 0.7, -0.6], a wektor do tokena cat to [0.3, -0.7, 0.9, -0.1]. Cztery wartości w wektorze. Widzisz to?
Może zapytasz skąd w ogóle te liczby i co one znaczą? To są przyjęte wartości początkowe przed treningiem sieci. Nikt nie usiadł i nie stwierdził, że pies jest bardziej zwierzęcy niż chomik to dam mu wartość wektora 0.7. No coś Ty. Robi to program zgodnie z określoną metodą inicjalizacji. Mogą one być wygenerowane losowo lub pseudolosowo, zależy jak to ustalił Inżynier.
Podczas treningu sieci z tymi tekstami, których masz ogrom, te wartości w wektorze będą aktualizowane. I nagle może okazać się, że za jakiś czas Twój token dog zmienił wektor na [0.62, -0.19, 0.72, -0.53].
I to na pewno nie dlatego, że Człowiek stwierdził, że 0.62 już oznacza psa, 0.19 łapę, natomiast 0.72 to sierść, a -0.53 to głośne szczekanie.
Przestrzeń
Wektor tak nie działa. I tu wchodzi na scenę przestrzeń. Ja wiem, aż chce się oddychać. Twój wektor ma cztery wartości, więc znajduje się w przestrzeni czterowymiarowej. A wektor mający sto wartości znajduje się w przestrzeni stuwymiarowej. O rany. Trudno nam sobie to wyobrazić, ale tak jak już mówiliśmy, matma nie ma z tym problemu.
Otrzymujesz ogromną matematyczna mapę. Już nie siedzi tam samotny token dog, ale ma spore towarzystwo. Podczas treningu wartości wektorów są aktualizowane w taki sposób, że w tej przestrzeni może wyłaniać się struktura: tokeny występujące w podobnych kontekstach i pełniące podobne role językowe mogą mieć podobne reprezentacje wektorowe. Twój dog może wykazywać większe podobieństwo do innych tokenów pojawiających się w podobnym kontekście, niż do tokenów w zupełnie innych kontekstach.
I teraz coś ciekawego: Ty nie będziesz tego nigdzie ręcznie umieszczał i rysował: dog z lewej strony, a cat po prawo trochę do góry, dwa centymetry wyżej. Nie.
Ta struktura pojawia się w wyniku uczenia sieci na danych (no wiesz, to te teksty, które masz w zanadrzu). Model uzyskuje liczbową reprezentację tokena, która daje informację o jego relacjach z innymi tokenami wynikających z danych treningowych.
I teraz wreszcie, Twój wektor [0.62, -0.19, 0.72, -0.53], który był na samym początku [0.7, -0.3, 0.7, -0.6] to – uwaga – embedding.
Tak. Nie pomyliłam się. Wektor tokena dog nazywa się embeddingiem. Mnie też ulżyło. Wreszcie wiemy.
Rola, jaką ma embedding
No i teraz się zacznie. Budujesz sieć i nie masz tylko jednego tokena ze swoim embeddingiem [0.7, -0.3, 0.7, -0.6]. Masz token cat, run, snow i wiele innych. Na przykład tysiąc. I każdy z tego tysiąca embeddingów ma cztery wartości – tak sobie założyłeś.
No to chcę Ci powiedzieć, że powstała Ci niezła macierz tysiąca embeddingów (wektorów) o czterech wartościach. Widzisz to? Tysiąc na cztery. Długi słupek. A gdzieś pośród nich stoi Twój dog z ID-452.
Kiedy w trakcie treningu sieci pojawia się dog, jego ID pozwala modelowi trafić do odpowiadającego mu embeddingu. I zamiast pracować na ID-452, model dalej pracuje na wektorowej reprezentacji tokena, której wartości są aktualizowane podczas treningu. Ale co to daje?
Masz gotową sieć. Siadasz przed komputerem, wpisujesz prompt: „Opisz psa rasy golden retriever”. Tokenizer rozbija tekst na tokeny i każdy z nich dostaje swoje ID. ID pozwalają modelowi odnaleźć odpowiadające im wyuczone embeddingi. Teraz model ma przewidzieć, co może pojawić się dalej.
Zaczyna się odpowiedź: „Golden retriever is…” Żeby dokończyć cały opis tej rasy psa, model musi wykorzystać informacje zawarte w całym dotychczasowym ciągu. Nie wystarczy mu wiedzieć, że ostatnim tokenem jest is. Musi uwzględnić, że wcześniej pojawiło się retriever, a jeszcze wcześniej Golden.
W tym miejscu po słowie is model nie wybiera kolejnego tokena przypadkowo. Embedding wnosi do modelu wyuczoną reprezentację tokena, która może zostać wykorzystana razem z reprezentacjami innych tokenów podczas obliczania tego, co powinno pojawić się dalej.
Udział w przewidywaniu kolejnego tokena. To jest jego rola w generowaniu.
Autor: Magdalena Siatkowska